NVIDIA Parakeet TDT सही Whisper विकल्प लग सकता है, जब तक कि यह आपकी भाषा या वर्कफ़्लो से न चूक जाए। आपके Mac पर रनटाइम उतना ही मायने रखता है जितना चेकपॉइंट।
संक्षिप्त जवाब: अगर आपका ऑडियो इसकी 25 समर्थित यूरोपीय भाषाओं में से किसी एक में है और आपको word टाइमस्टैम्प वाला 600M-पैरामीटर मॉडल चाहिए, तो Parakeet TDT v3 चुनें। जब आपको व्यापक भाषा कवरेज या अंग्रेज़ी में ट्रांसलेशन चाहिए हो तो Whisper large-v3 चुनें; अगर आपको छोटा Whisper चेकपॉइंट चाहिए तो large-v3-turbo चुनें। Open ASR Leaderboard पेपर की अंग्रेज़ी टेबल में Parakeet v3 का औसत WER दोनों Whisper चेकपॉइंट से कम है, और शॉर्ट-फ़ॉर्म ऑडियो पर यह उसी GPU पर 17–23 गुना तेज़ चलता है; पाँच यूरोपीय भाषाओं पर यह WER में Whisper large-v3 के बराबर है। वे GPU स्पीड आपके Mac पर परफ़ॉर्मेंस का अनुमान नहीं लगातीं, इसलिए पहले एक रनटाइम चुनें, फिर उन क्लिप्स पर दोनों मॉडल की तुलना करें जिन्हें आप असल में ट्रांसक्राइब करते हैं।
NVIDIA Parakeet TDT क्या है, और यह Whisper से कैसे अलग है?
Parakeet TDT एक FastConformer ऑडियो एनकोडर और Token-and-Duration Transducer डिकोडर इस्तेमाल करता है। Whisper एक encoder-decoder Transformer इस्तेमाल करता है जो एक बार में एक टोकन टेक्स्ट जनरेट करता है। TDT यह अनुमान लगाता है कि एक टोकन कितनी देर तक फैला है, और डिकोड करते समय उन ऑडियो फ़्रेम को छोड़ सकता है। TDT पेपर उस फ़्रेम-स्किपिंग मैकेनिज़्म का वर्णन करता है; Whisper पेपर अपने encoder-decoder डिज़ाइन का वर्णन करता है।
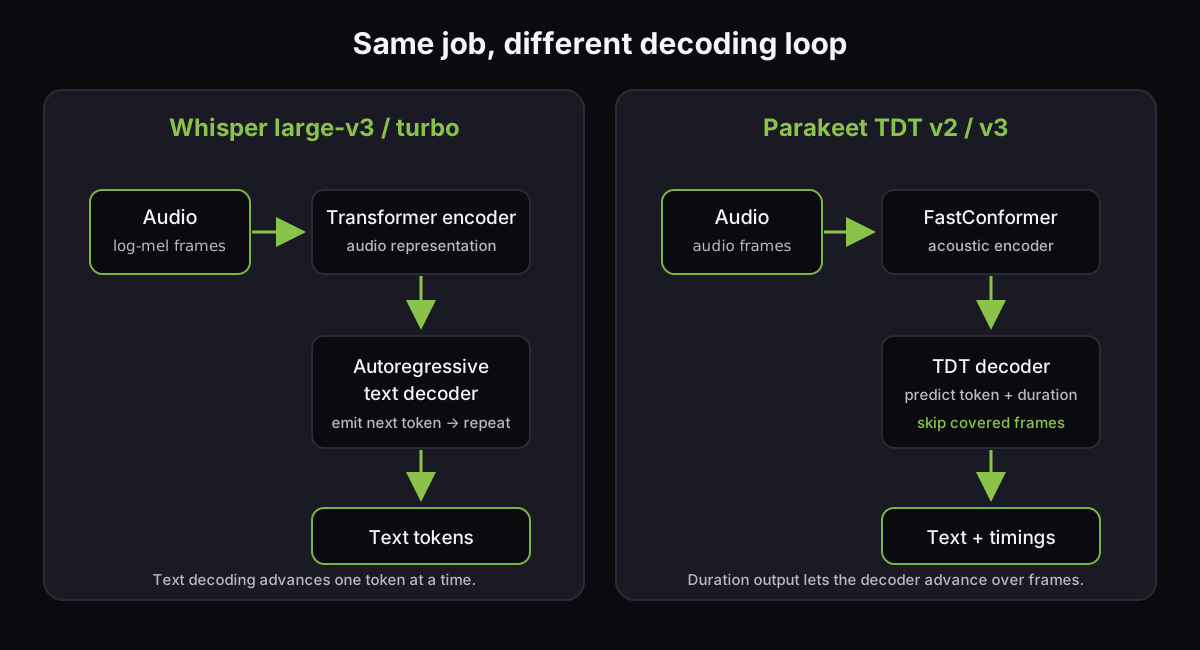
वह आर्किटेक्चर Parakeet के प्रकाशित थ्रूपुट को समझने में मदद करता है; यह साबित नहीं करता कि आपके ऑडियो के ट्रांसक्रिप्ट बेहतर होंगे। large-v3 मॉडल कार्ड के अनुसार Whisper 99 भाषाएँ कवर करता है, और Whisper README अंग्रेज़ी में स्पीच ट्रांसलेशन डॉक्युमेंट करता है। Parakeet v3 अपनी समर्थित भाषाओं में से एक को अपने आप पहचान लेता है, और उसके मॉडल कार्ड में चेतावनी है कि एक्युरेसी एक्सेंट, शोर, डोमेन और स्पीच टाइप के साथ बदलती है। इससे यह नतीजा न निकालें कि दोनों में से कोई भी मॉडल ख़ामोशी के दौरान शब्द कभी नहीं गढ़ता; नीचे दिए बेंचमार्क आँकड़े उस व्यवहार को नहीं मापते।
Parakeet v2, v3, Whisper large-v3 और turbo की तुलना कैसी है?
Open ASR Leaderboard पेपर (arXiv v4, March 30, 2026) शॉर्ट-फ़ॉर्म अंग्रेज़ी पर चारों चेकपॉइंट और लॉन्ग-फ़ॉर्म अंग्रेज़ी पर उनमें से तीन की रिपोर्ट देता है। WER में कम बेहतर है; RTFx यह है कि मॉडल प्रति सेकंड कंप्यूट पर ऑडियो के कितने सेकंड ट्रांसक्राइब करता है, इसलिए ज़्यादा यानी तेज़।
| चेकपॉइंट | पैरामीटर | भाषाएँ | लाइसेंस | अंग्रेज़ी शॉर्ट-फ़ॉर्म WER / RTFx | अंग्रेज़ी लॉन्ग-फ़ॉर्म WER / RTFx |
|---|---|---|---|---|---|
| Parakeet TDT v2 | 600M | अंग्रेज़ी | CC BY 4.0 | 6.05% / 3,390 | पेपर के सबसेट में नहीं |
| Parakeet TDT v3 | 600M | 25 यूरोपीय | CC BY 4.0 | 6.32% / 3,330 | 10.7% / 1,000 |
| Whisper large-v3 | 1.55B | 99 | OpenAI के रिपो में MIT; HF कार्ड मेटाडेटा Apache-2.0 कहता है | 7.44% / 146 | 11.2% / 68.6 |
| Whisper large-v3-turbo | 809M | 99 | MIT | 7.83% / 200 | 11.0% / 148 |
पेपर की मल्टीलिंगुअल टेबल पर, जो जर्मन, फ़्रेंच, इटैलियन, स्पैनिश और पुर्तगाली का औसत है, Parakeet v3 और Whisper large-v3 दोनों का औसत WER 4.81% है, RTFx 1,720 और 111 के साथ। जर्मन और फ़्रेंच पर Parakeet आगे है, इटैलियन, स्पैनिश और पुर्तगाली पर Whisper। ये स्कोर लीडरबोर्ड पेपर की Tables 3–5 से आते हैं, जो हर मॉडल को एक NVIDIA A100-SXM4-80GB पर चलाता है — बैच साइज़ 64 जब मेमोरी की अनुमति हो, वरना छोटे बैच। RTFx को एक ही हार्डवेयर की तुलना मानें, Apple Silicon का अनुमान नहीं, और नई पंक्तियों के लिए लाइव लीडरबोर्ड देखें।
v2 कार्ड सिर्फ़ अंग्रेज़ी ट्रांसक्रिप्शन बताता है, जबकि NVIDIA के v3 कार्ड में 25 भाषाओं के नाम हैं: बुल्गारियाई, क्रोएशियाई, चेक, डैनिश, डच, अंग्रेज़ी, एस्टोनियाई, फ़िनिश, फ़्रेंच, जर्मन, ग्रीक, हंगेरियाई, इटैलियन, लातवियाई, लिथुआनियाई, माल्टीज़, पोलिश, पुर्तगाली, रोमानियाई, रूसी, स्लोवाक, स्लोवेनियाई, स्पैनिश, स्वीडिश और यूक्रेनियाई।
OpenAI का Whisper README कहता है कि वेट्स और कोड MIT इस्तेमाल करते हैं। Hugging Face का large-v3 कार्ड इस समय अपने मेटाडेटा पर Apache-2.0 लेबल लगाता है, इसलिए सिर्फ़ तुलना टेबल पर भरोसा करने के बजाय अपनी इच्छित डिस्ट्रीब्यूशन के लिए लागू फ़ाइलें ख़ुद जाँचें। Turbo के मॉडल कार्ड में MIT है।
दोनों Parakeet कार्ड ऑटोमैटिक पंक्चुएशन और कैपिटलाइज़ेशन के साथ word-लेवल टाइमस्टैम्प डॉक्युमेंट करते हैं। Whisper टाइमस्टैम्प वाले सेगमेंट देता है; mlx-whisper का README अपने ट्रांसक्रिप्शन आउटपुट में word-लेवल टाइमस्टैम्प डॉक्युमेंट करता है। Large-v3-turbo, उसके मॉडल कार्ड के अनुसार, एक प्रून्ड large-v3 है जिसमें 32 की जगह चार डिकोडर लेयर हैं। इसका छोटा आकार थोड़ी एक्युरेसी के बदले थ्रूपुट देता है।
भाषाओं, ट्रांसलेशन या लंबी रिकॉर्डिंग के लिए मुझे कौन-सा मॉडल चुनना चाहिए?
पहले अपनी ज़रूरी भाषा और आउटपुट देखें, फिर बेंचमार्क स्कोर को टाई-ब्रेकर की तरह इस्तेमाल करें।
| चुनाव | कब फ़िट बैठता है | क़ीमत या सीमा |
|---|---|---|
| Parakeet TDT v2 | सिर्फ़ अंग्रेज़ी ट्रांसक्रिप्शन, पंक्चुएशन और वर्ड टाइमिंग के साथ | कोई मल्टीलिंगुअल कवरेज नहीं |
| Parakeet TDT v3 | उसकी सूचीबद्ध 25 यूरोपीय भाषाओं में से कोई एक; आपको TDT आर्किटेक्चर और वर्ड टाइमिंग चाहिए | हिंदी, थाई, जापानी, अरबी या चीनी को सपोर्टेड भाषाओं के रूप में ट्रांसक्राइब नहीं कर सकता; मॉडल कार्ड कहता है कि यह बिना प्रॉम्प्ट के भाषा पहचान लेता है, इसलिए छोटे क्लिप्स पर ग़लत पहचान जाँचने की योजना रखें |
| Whisper large-v3 | Whisper की 99-भाषा वाली सूची में से कोई भाषा, या ग़ैर-अंग्रेज़ी स्पीच का अंग्रेज़ी में अनुवाद | 1.55B पैरामीटर; बड़ा चेकपॉइंट |
| Whisper large-v3-turbo | pruned 809M चेकपॉइंट के साथ Whisper की भाषा कवरेज | Turbo अनुवाद के लिए ट्रेन नहीं किया गया है; उस काम के लिए पूरा large-v3 इस्तेमाल करें |
लंबी रिकॉर्डिंग के लिए मॉडल की सीमाओं और रनटाइम की चंकिंग में फ़र्क़ समझें। NVIDIA कहता है कि Parakeet v3 एक 80 GB A100 पर फुल अटेंशन के साथ 24 मिनट तक, या लोकल अटेंशन के साथ तीन घंटे तक सपोर्ट करता है। V2 का कार्ड कहता है कि प्रति पास 24 मिनट तक। Whisper का मूल पेपर 30-सेकंड के इनपुट सेगमेंट का वर्णन करता है; इसका ऑफ़िशियल README लंबे ऑडियो की ट्रांसक्रिप्शन का रास्ता डॉक्युमेंट करता है। Mac पर प्रोडक्शन वर्कफ़्लो चुनने से पहले रनटाइम की मेमोरी खपत और चंकिंग व्यवहार को पूरी लंबाई वाली रिकॉर्डिंग के साथ जाँचें।
Parakeet या Whisper को Mac पर लोकली कैसे चलाएँ?
ज़रूरी शर्तें: FluidAudio का Swift पैकेज macOS 14+ और Swift tools 6.0 डिक्लेयर करता है। MLX वाले रास्ते Apple Silicon को टारगेट करते हैं, और एक parakeet-mlx issue macOS 14 पर एक फ़ेलियर रिपोर्ट करता है जिसकी वजह macOS 15 में उपलब्ध एक API है, इसलिए उस रास्ते के लिए macOS 15+ इस्तेमाल करें, जब तक कि आप कोई संगत MLX वर्ज़न न जाँच लें। whisper.cpp Intel और Apple Silicon दोनों Mac सपोर्ट करता है। पैकेज के README Python/MLX वर्ज़नों का कोई साझा सेट तय नहीं करते।
नीचे दी गई कमांड docs-only हैं: उनके README इन्हें डॉक्युमेंट करते हैं, लेकिन हमने इस आर्टिकल के लिए कोई मॉडल इंस्टॉल या रन नहीं किया। पहली बार चलाने पर कई गीगाबाइट वेट डाउनलोड हो सकते हैं, इसलिए पहले चुने हुए मॉडल की डिस्क और मेमोरी ज़रूरतें देख लें।
Core ML और FluidAudio के ज़रिए Parakeet: यह Swift रनटाइम तब चुनें जब आपको इसकी Core ML पाइपलाइन चाहिए, जो Apple के Neural Engine का इस्तेमाल कर सकती है। FluidAudio के चेकआउट में डॉक्युमेंटेड CLI फ़ॉर्म यह है:
swift run fluidaudiocli transcribe meeting.wav
अपेक्षित नतीजा: WAV फ़ाइल के लिए ट्रांसक्रिप्ट प्रिंट होता है; पहली बार मॉडल लोड होने पर Core ML एसेट्स डाउनलोड होते हैं। FluidAudio README इस रास्ते और इसके v3 मॉडल को डॉक्युमेंट करता है। इसके लिए एक Swift प्रोजेक्ट या रिपॉज़िटरी चेकआउट चाहिए; यह कोई आम शेल पैकेज इंस्टॉल नहीं है।
Parakeet MLX: Apple Silicon GPU वाले रास्ते के लिए यह Python CLI चुनें। पहले ffmpeg इंस्टॉल करें, जैसा README कहता है, फिर चलाएँ:
brew install ffmpeg
uv tool install parakeet-mlx -U
parakeet-mlx meeting.wav --output-format txt
अपेक्षित नतीजा: meeting.wav के लिए एक टेक्स्ट ट्रांसक्रिप्ट फ़ाइल; डिफ़ॉल्ट मॉडल mlx-community/parakeet-tdt-0.6b-v3 है। parakeet-mlx README इंस्टॉलेशन, आउटपुट फ़ॉर्मैट और डिफ़ॉल्ट चेकपॉइंट को डॉक्युमेंट करता है।
MLX Whisper: यह रास्ता तब चुनें जब आप Apple Silicon GPU पर Whisper और एक Python API चाहते हों। कन्वर्ट किए हुए turbo चेकपॉइंट से इंस्टॉल करें और ट्रांसक्राइब करें:
brew install ffmpeg
python -m pip install mlx-whisper
mlx_whisper meeting.wav --model mlx-community/whisper-large-v3-turbo
अपेक्षित नतीजा: CLI एक ट्रांसक्रिप्ट फ़ाइल लिखता है; MLX Whisper README पैकेज और CLI को डॉक्युमेंट करता है, और कन्वर्ट किया हुआ turbo चेकपॉइंट MLX Community से मिलता है। वर्ड टाइमस्टैम्प के लिए इसका Python API word_timestamps=True के साथ इस्तेमाल करें।
whisper.cpp के ज़रिए Whisper: Metal और वैकल्पिक Core ML एनकोडर सपोर्ट वाले नेटिव CLI के लिए यह C/C++ रनटाइम चुनें। इसकी रिपॉज़िटरी से:
git clone https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
sh ./models/download-ggml-model.sh base.en
cmake -B build
cmake --build build -j --config Release
./build/bin/whisper-cli -f samples/jfk.wav
अपेक्षित नतीजा: टर्मिनल में सैंपल ट्रांसक्रिप्ट दिखता है। यह क्विक स्टार्ट base.en इस्तेमाल करता है, जो सिर्फ़ अंग्रेज़ी वाला 74M-पैरामीटर चेकपॉइंट है; Whisper large-v3 से तुलना के लिए कोई सपोर्टेड मल्टीलिंगुअल GGML मॉडल चुनें। whisper.cpp README में Metal और Core ML सपोर्ट दर्ज है। Apple Silicon पर इसका वैकल्पिक Core ML एनकोडर बनाने के लिए वही रिपॉज़िटरी सेटअप फ़ॉलो करें, फिर चलाएँ:
python3.11 -m pip install ane_transformers openai-whisper coremltools
./models/generate-coreml-model.sh base.en
cmake -B build -DWHISPER_COREML=1
cmake --build build -j --config Release
./build/bin/whisper-cli -m models/ggml-base.en.bin -f samples/jfk.wav
अपेक्षित नतीजा: टर्मिनल एक ट्रांसक्रिप्ट छापता है और बताता है कि मेल खाता Core ML एनकोडर लोड हो गया। पहली बार लोड करते समय मॉडल Neural Engine के लिए कंपाइल हो सकता है। README कहता है कि यह एनकोडर सिर्फ़ CPU पर होने वाले एक्ज़िक्यूशन से 3× से ज़्यादा तेज़ चल सकता है, लेकिन उस कथन में कोई मैच्ड Mac बेंचमार्क नहीं दिया गया।
FluidAudio बेंचमार्क लॉग के मुताबिक़ Parakeet v3 ने 2,620 फ़ाइलों और 5.40 घंटे वाले LibriSpeech test-clean सेट पर 155.6× ओवरऑल RTFx और 2.5% औसत WER दिया, जिसे 48 GB RAM और macOS 26.0 वाले 2024 M4 Pro पर नापा गया।
यह नतीजा FluidAudio के सेटअप का है; दोनों MLX README में से किसी में भी कंट्रोल्ड Mac स्पीड फ़िगर नहीं छपा है। इन आँकड़ों से एक जैसे हालात में रनटाइम की तुलना नहीं बनती। यहाँ दी गई सारी कमांड इस मशीन पर अब भी अनवेरिफ़ाइड हैं।
macOS 14 पर एक parakeet-mlx इशू में macOS 15 में जोड़े गए एक Metal API पर क्रैश की रिपोर्ट है; OS अपग्रेड करें या कोई कम्पैटिबल MLX वर्ज़न इस्तेमाल करें। अगर स्ट्रीमिंग add_audio() से TypeError आता है, तो एक और इशू कहता है कि NumPy इनपुट को mx.array(...) से कनवर्ट करें।
अगर whisper.cpp का Core ML मॉडल लोड नहीं होता, तो उसके एनकोडर बंडल को चुने हुए चेकपॉइंट से मिलाएँ; एक Mac इशू Apple Silicon पर रन-टाइम Metal कर्नल एरर इकट्ठा करता है, इसलिए अगर आप ऐसी किसी समस्या से टकराएँ तो अपने macOS और Xcode वर्ज़न नोट कर लें। ये रिपोर्ट किए गए केस हैं, हर जगह होने वाली ख़राबी नहीं।
Whisper की जगह लेने से पहले मुझे क्या टेस्ट करना चाहिए?
हर कैंडिडेट पर वही ऑडियो एक ही नॉर्मलाइज़ेशन के साथ चलाएँ और ट्रांसक्रिप्ट में किए सुधार व वॉल-क्लॉक समय, दोनों नोट करें।
अपने ही काम से 10–20 क्लिप लें: शांत डिक्टेशन, बैकग्राउंड नॉइज़, नाम या तकनीकी शब्द, छोटे पॉज़, और एक लंबी रिकॉर्डिंग। हर रेफ़रेंस ट्रांसक्रिप्ट सँभाल कर रखें।
हर रनटाइम के लिए मॉडल/वर्ज़न, भाषा, ऑडियो की अवधि, पहली रन पर डाउनलोड, पहला टेक्स्ट आने में लगा समय, कुल समय, पीक मेमोरी (अगर मिले) और वर्ड एरर दर्ज करें। पंक्चुएशन की तुलना अलग से करें, क्योंकि लीडरबोर्ड पंक्चुएशन और केसिंग को नॉर्मलाइज़ करके हटा देता है। हर क्लिप दो बार दोहराएँ ताकि मॉडल लोडिंग को ट्रांसक्रिप्शन की स्पीड न समझ लिया जाए।
अगर आपको फ़िक्स्ड आउटपुट भाषा, कस्टम वोकैबुलरी या साइलेंस पर भरोसेमंद बर्ताव चाहिए, तो ठीक वे केस शामिल करें। NVIDIA के मॉडल कार्ड में चेताया गया है कि उसके लैंग्वेज मॉडल में मौजूद न होने वाले शब्द छूट सकते हैं; Vext के प्रोडक्ट इम्प्लीमेंटेशन में भी एक अलग वैकल्पिक वोकैबुलरी बूस्टर इस्तेमाल होता है। हमारा पिछला ऑन-डिवाइस स्पीच रिकग्निशन नोट बताता है कि हम ऑडियो का रास्ता लोकल क्यों रखते हैं, लेकिन वह आपके अपने शब्दों और लहजों की माप की जगह नहीं ले सकता।
Vext में यह चुनाव कैसा दिखता है?
हम Vext बनाते हैं, एक Mac वॉइस-टू-टेक्स्ट ऐप जो Apple के Neural Engine पर FluidAudio और Core ML के ज़रिए Parakeet TDT v3 इस्तेमाल करता है। इसका Parakeet डाउनलोड लगभग 483 MB है और वही 25 यूरोपीय भाषाएँ कवर करता है; बाक़ी भाषाएँ Apple Speech पर चली जाती हैं, और Vext में लोकल Whisper बंडल नहीं होता।
हमने Vext के टू-पास डायराइज़ेशन और भाषा सपोर्ट पर भी लिखा है। इसके README में टेस्ट की स्थितियाँ दर्ज किए बिना “~150x realtime” लिखा है; सबसे नज़दीकी मापा हुआ आँकड़ा ऊपर M4 Pro पर FluidAudio का अपना 155.6× है, और वह उस लाइब्रेरी के लिए है जिसे Vext चलाता है, ख़ुद Vext के लिए नहीं।
अगर आपकी भाषा Parakeet v3 की लिस्ट में है, तो Parakeet और किसी ऐसे Mac रनटाइम से शुरुआत करें जिसे आप मेंटेन कर सकें। अगर आपको Whisper का व्यापक भाषा सपोर्ट या अंग्रेज़ी में ट्रांसलेशन चाहिए, तो large-v3 इस्तेमाल करें; अगर आपको Whisper का छोटा वेरिएंट चाहिए और ट्रांसलेशन नहीं चाहिए, तो turbo की तुलना करें। फिर विजेता को तभी रखें जब वह आपके अपने ऑडियो पर आपके ट्रांसक्रिप्ट सुधारता हो।
— Don
दोनों इंजन पर वही क्लिप आज़माएँ और अपने मॉडल, रनटाइम व हार्डवेयर के नोट्स हमें GitHub पर साझा करें।