NVIDIA Parakeet TDT อาจดูเหมือนเป็นทางเลือกแทน Whisper ที่ใช่ จนกระทั่งมันไม่รองรับภาษาหรือเวิร์กโฟลว์ของคุณ runtime บน Mac ของคุณสำคัญพอ ๆ กับตัว checkpoint
คำตอบสั้น ๆ: เลือก Parakeet TDT v3 ถ้าเสียงของคุณอยู่ใน 25 ภาษายุโรปที่มันรองรับและคุณอยากได้โมเดลขนาด 600M พารามิเตอร์ที่มี word timestamp เลือก Whisper large-v3 เมื่อคุณต้องการครอบคลุมภาษากว้าง ๆ หรือแปลเป็นภาษาอังกฤษ เลือก large-v3-turbo เมื่อคุณอยากได้ checkpoint ของ Whisper ที่เล็กลง ในตารางภาษาอังกฤษของเปเปอร์ Open ASR Leaderboard นั้น Parakeet v3 มี WER เฉลี่ยต่ำกว่าทั้งสอง checkpoint ของ Whisper และบนเสียงแบบสั้นมันรันเร็วกว่า 17–23 เท่าบน GPU ตัวเดียวกัน ส่วนในห้าภาษายุโรปมันเสมอกับ Whisper large-v3 ในแง่ WER ความเร็วบน GPU เหล่านั้นไม่ได้บอกล่วงหน้าถึงประสิทธิภาพบน Mac ของคุณ ดังนั้นเลือก runtime ก่อน แล้วค่อยเทียบทั้งสองโมเดลกับคลิปที่คุณถอดเสียงจริง
NVIDIA Parakeet TDT คืออะไร และต่างจาก Whisper อย่างไร?
Parakeet TDT ใช้ FastConformer เป็น audio encoder และใช้ Token-and-Duration Transducer เป็น decoder ส่วน Whisper ใช้ Transformer แบบ encoder-decoder ที่สร้างข้อความทีละ token TDT จะทำนายว่า token หนึ่งครอบคลุมเสียงนานเท่าไร และข้าม audio frame ช่วงนั้นไประหว่าง decoding ได้ เปเปอร์ TDT อธิบายกลไกการข้ามเฟรมนั้นไว้ ส่วนเปเปอร์ Whisper อธิบายดีไซน์แบบ encoder-decoder ของมัน
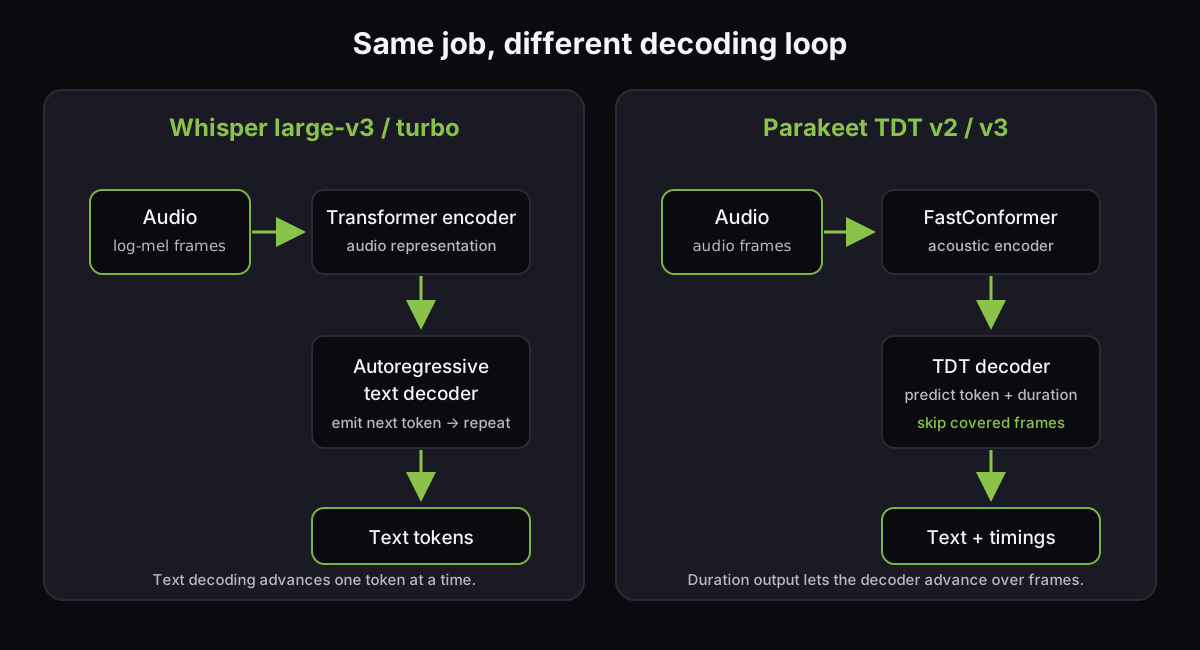
สถาปัตยกรรมนั้นช่วยอธิบาย throughput ที่ Parakeet ตีพิมพ์ไว้ แต่มันไม่ได้พิสูจน์ว่าได้ transcript ที่ดีกว่าสำหรับเสียงของคุณ Whisper ครอบคลุม 99 ภาษาตามการ์ดโมเดล large-v3 และ Whisper README ก็ระบุเรื่องการแปลเสียงพูดเป็นภาษาอังกฤษไว้ Parakeet v3 ตรวจจับหนึ่งในภาษาที่มันรองรับได้เองโดยอัตโนมัติ และการ์ดโมเดลของมันเตือนว่าความแม่นยำแปรผันตามสำเนียง เสียงรบกวน โดเมน และลักษณะการพูด อย่าสรุปเอาว่าโมเดลใดก็ตามจะไม่เคยแต่งคำขึ้นมาเองในช่วงที่เงียบ ตัวเลขเบนช์มาร์กข้างล่างไม่ได้วัดพฤติกรรมนั้น
Parakeet v2, v3, Whisper large-v3 และ turbo เทียบกันเป็นอย่างไร?
เปเปอร์ Open ASR Leaderboard (arXiv v4, March 30, 2026) รายงานผลของทั้งสี่ checkpoint บนเสียงภาษาอังกฤษแบบสั้น และสามตัวในนั้นบนเสียงภาษาอังกฤษแบบยาว WER ยิ่งต่ำยิ่งดี ส่วน RTFx คือจำนวนวินาทีของเสียงที่โมเดลถอดได้ต่อการประมวลผลหนึ่งวินาที ดังนั้นยิ่งสูงยิ่งเร็ว
| Checkpoint | พารามิเตอร์ | ภาษา | ไลเซนส์ | WER / RTFx ภาษาอังกฤษแบบสั้น | WER / RTFx ภาษาอังกฤษแบบยาว |
|---|---|---|---|---|---|
| Parakeet TDT v2 | 600M | อังกฤษ | CC BY 4.0 | 6.05% / 3,390 | ไม่อยู่ในชุดย่อยของเปเปอร์ |
| Parakeet TDT v3 | 600M | 25 ภาษายุโรป | CC BY 4.0 | 6.32% / 3,330 | 10.7% / 1,000 |
| Whisper large-v3 | 1.55B | 99 | MIT ใน repo ของ OpenAI; metadata ของการ์ดบน HF ระบุ Apache-2.0 | 7.44% / 146 | 11.2% / 68.6 |
| Whisper large-v3-turbo | 809M | 99 | MIT | 7.83% / 200 | 11.0% / 148 |
ในตารางหลายภาษาของเปเปอร์ ซึ่งเฉลี่ยจากภาษาเยอรมัน ฝรั่งเศส อิตาลี สเปน และโปรตุเกส ทั้ง Parakeet v3 และ Whisper large-v3 ทำได้ WER เฉลี่ย 4.81% เท่ากัน ที่ RTFx 1,720 และ 111 ตามลำดับ Parakeet นำในภาษาเยอรมันและฝรั่งเศส ส่วน Whisper นำในภาษาอิตาลี สเปน และโปรตุเกส คะแนนเหล่านี้มาจากตารางที่ 3–5 ของเปเปอร์ลีดเดอร์บอร์ด ซึ่งรันทุกโมเดลบน NVIDIA A100-SXM4-80GB ตัวเดียว ด้วย batch size 64 เมื่อหน่วยความจำพอ และ batch ที่เล็กลงเมื่อไม่พอ ให้มอง RTFx ว่าเป็นการเปรียบเทียบบนฮาร์ดแวร์เดียวกัน ไม่ใช่ค่าประมาณของ Apple Silicon และเช็กลีดเดอร์บอร์ดที่อัปเดตสดเพื่อดูแถวที่ใหม่กว่า
การ์ด v2 ระบุการถอดเสียงเฉพาะภาษาอังกฤษ ขณะที่การ์ด v3 ของ NVIDIA ระบุชื่อ 25 ภาษา: บัลแกเรีย โครเอเชีย เช็ก เดนมาร์ก ดัตช์ อังกฤษ เอสโตเนีย ฟินแลนด์ ฝรั่งเศส เยอรมัน กรีก ฮังการี อิตาลี ลัตเวีย ลิทัวเนีย มอลตา โปแลนด์ โปรตุเกส โรมาเนีย รัสเซีย สโลวัก สโลวีเนีย สเปน สวีเดน และยูเครน
Whisper README ของ OpenAI บอกว่า weights และโค้ดใช้ MIT ส่วนการ์ด large-v3 บน Hugging Face ตอนนี้ติดป้าย metadata เป็น Apache-2.0 ดังนั้นให้เช็คไฟล์ที่มีผลบังคับใช้จริงสำหรับการแจกจ่ายที่คุณตั้งใจไว้ แทนที่จะพึ่งตารางเปรียบเทียบอย่างเดียว การ์ดโมเดลของ turbo ระบุ MIT
การ์ด Parakeet ทั้งสองใบ ระบุเรื่องการใส่เครื่องหมายวรรคตอนและตัวพิมพ์ใหญ่โดยอัตโนมัติ บวกกับ word-level timestamp ส่วน Whisper ให้ segment ที่มี timestamp มาด้วย README ของ mlx-whisper ระบุ word-level timestamp ในเอาต์พุตการถอดเสียงของมัน Large-v3-turbo คือ large-v3 ที่ถูก prune ให้เหลือ decoder สี่เลเยอร์แทนที่จะเป็น 32 ตามการ์ดโมเดลของมัน ขนาดที่เล็กลงแลกความแม่นยำบางส่วนไปกับ throughput
ควรเลือกโมเดลไหนสำหรับเรื่องภาษา การแปล หรือการบันทึกเสียงยาว ๆ?
เริ่มจากภาษาและเอาต์พุตที่คุณต้องการก่อน แล้วค่อยใช้คะแนนเบนช์มาร์กเป็นตัวตัดสินเมื่อเสมอกัน
| ตัวเลือก | เหมาะเมื่อ | ต้นทุนหรือข้อจำกัด |
|---|---|---|
| Parakeet TDT v2 | ถอดเสียงเฉพาะภาษาอังกฤษ พร้อมวรรคตอนและเวลาของแต่ละคำ | ไม่ครอบคลุมหลายภาษา |
| Parakeet TDT v3 | หนึ่งใน 25 ภาษายุโรปที่มันระบุไว้ คุณอยากได้สถาปัตยกรรม TDT และเวลาของแต่ละคำ | ถอดเสียงภาษาฮินดี ไทย ญี่ปุ่น อาหรับ หรือจีนในฐานะภาษาที่รองรับไม่ได้ การ์ดโมเดลบอกว่ามันตรวจจับภาษาได้โดยไม่ต้องใช้พรอมต์ ดังนั้นวางแผนไว้ว่าจะต้องเช็คการตรวจจับผิดบนคลิปสั้น ๆ |
| Whisper large-v3 | ภาษาที่อยู่ในลิสต์ 99 ภาษาของ Whisper หรือการแปลเสียงที่ไม่ใช่ภาษาอังกฤษให้เป็นภาษาอังกฤษ | 1.55B พารามิเตอร์ checkpoint ใหญ่กว่า |
| Whisper large-v3-turbo | ครอบคลุมภาษาแบบ Whisper ด้วย checkpoint ที่ prune แล้วขนาด 809M | turbo ไม่ได้ถูกเทรนมาเพื่อการแปล ให้ใช้ large-v3 ตัวเต็มสำหรับงานนั้น |
สำหรับเสียงบันทึกยาว ๆ ให้แยกให้ออกระหว่างขีดจำกัดของโมเดลกับการแบ่ง chunk ของ runtime NVIDIA บอกว่า Parakeet v3 รองรับได้สูงสุด 24 นาทีด้วย full attention บน A100 ขนาด 80 GB หรือสูงสุดสามชั่วโมงด้วย local attention การ์ดของ v2 บอกว่าสูงสุด 24 นาทีต่อหนึ่งรอบ เปเปอร์ต้นฉบับของ Whisper อธิบาย segment อินพุตยาว 30 วินาที ส่วน README อย่างเป็นทางการระบุเส้นทางถอดเสียงยาวไว้ บน Mac ให้ทดสอบการใช้หน่วยความจำและพฤติกรรมการแบ่ง chunk ของ runtime ด้วยเสียงบันทึกความยาวเต็มก่อนเลือกเวิร์กโฟลว์ที่จะใช้จริง
จะรัน Parakeet หรือ Whisper แบบโลคัลบน Mac ได้อย่างไร?
สิ่งที่ต้องมี: Swift package ของ FluidAudio ประกาศว่าต้องใช้ macOS 14+ และ Swift tools 6.0 เส้นทาง MLX เล็งไปที่ Apple Silicon และissue ของ parakeet-mlx รายงานว่าการรันล้มเหลวบน macOS 14 เพราะไปใช้ API ซึ่งมีใน macOS 15 ดังนั้นใช้ macOS 15+ สำหรับเส้นทางนั้น เว้นแต่คุณจะยืนยันได้ว่ามีเวอร์ชัน MLX ที่เข้ากันได้ whisper.cpp รองรับ Mac ทั้ง Intel และ Apple Silicon README ของแต่ละแพ็กเกจไม่ได้ล็อกเวอร์ชัน Python/MLX ชุดกลางไว้
คำสั่งข้างล่างเป็นแบบ docs-only: README ของมันระบุไว้ แต่เราไม่ได้ติดตั้งหรือรันโมเดลใด ๆ สำหรับบทความนี้ การรันครั้งแรกอาจดาวน์โหลด weights หลายกิกะไบต์ ดังนั้นเช็คความต้องการดิสก์และหน่วยความจำของโมเดลที่เลือกไว้ก่อน
Parakeet ผ่าน Core ML และ FluidAudio: เลือก Swift runtime นี้เมื่อคุณอยากได้ pipeline Core ML ของมัน ซึ่งใช้ Neural Engine ของ Apple ได้ ใน checkout ของ FluidAudio รูปแบบ CLI ที่ระบุในเอกสารคือ:
swift run fluidaudiocli transcribe meeting.wav
ผลที่คาด: transcript ของไฟล์ WAV ถูกพิมพ์ออกมา การโหลดโมเดลครั้งแรกจะดาวน์โหลด asset ของ Core ML FluidAudio README ระบุเส้นทางนี้และโมเดล v3 ของมันไว้ วิธีนี้ต้องมี Swift project หรือ checkout ของ repo มันไม่ใช่การติดตั้งแพ็กเกจผ่าน shell แบบทั่วไป
Parakeet MLX: เลือก Python CLI นี้สำหรับเส้นทาง GPU ของ Apple Silicon ติดตั้ง ffmpeg ก่อนตามที่ README กำหนด แล้วรัน:
brew install ffmpeg
uv tool install parakeet-mlx -U
parakeet-mlx meeting.wav --output-format txt
ผลที่คาด: ไฟล์ transcript แบบข้อความสำหรับ meeting.wav โมเดลดีฟอลต์คือ mlx-community/parakeet-tdt-0.6b-v3 README ของ parakeet-mlx ระบุเรื่องการติดตั้ง รูปแบบเอาต์พุต และ checkpoint ดีฟอลต์ไว้
MLX Whisper: เลือกเส้นทางนี้ถ้าคุณอยากได้ Whisper บน GPU ของ Apple Silicon พร้อม Python API ติดตั้งแล้วถอดเสียงด้วย turbo checkpoint ที่แปลงแล้ว:
brew install ffmpeg
python -m pip install mlx-whisper
mlx_whisper meeting.wav --model mlx-community/whisper-large-v3-turbo
ผลที่คาด: CLI เขียนไฟล์ transcript ออกมา MLX Whisper README ระบุเรื่องแพ็กเกจและ CLI ไว้ และturbo checkpoint ที่แปลงแล้วก็มีให้ใช้จาก MLX Community ถ้าต้องการ word timestamp ให้ใช้ Python API ของมันพร้อม word_timestamps=True
Whisper ผ่าน whisper.cpp: เลือก C/C++ runtime นี้เพื่อ CLI แบบ native ที่รองรับ Metal และมี Core ML encoder เป็นออปชัน จาก repo ของมัน:
git clone https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
sh ./models/download-ggml-model.sh base.en
cmake -B build
cmake --build build -j --config Release
./build/bin/whisper-cli -f samples/jfk.wav
ผลที่คาด: transcript ตัวอย่างปรากฏขึ้นในเทอร์มินัล quick start นี้ใช้ base.en ซึ่งเป็น checkpoint ขนาด 74M พารามิเตอร์ที่รองรับเฉพาะภาษาอังกฤษ ให้เลือกโมเดล GGML แบบหลายภาษาที่รองรับถ้าจะเทียบกับ Whisper large-v3 README ของ whisper.cpp ระบุเรื่องการรองรับ Metal และ Core ML ไว้ ถ้าจะบิลด์ Core ML encoder ที่เป็นออปชันบน Apple Silicon ให้ทำตามขั้นตอนตั้งค่า repo เดิม แล้วรัน:
python3.11 -m pip install ane_transformers openai-whisper coremltools
./models/generate-coreml-model.sh base.en
cmake -B build -DWHISPER_COREML=1
cmake --build build -j --config Release
./build/bin/whisper-cli -m models/ggml-base.en.bin -f samples/jfk.wav
ผลที่คาด: เทอร์มินัลพิมพ์ transcript ออกมาและรายงานว่า Core ML encoder ที่ตรงกันถูกโหลดแล้ว การโหลดครั้งแรกอาจคอมไพล์โมเดลสำหรับ Neural Engine README บอกว่า encoder นี้รันได้เร็วกว่าการรันบน CPU อย่างเดียวกว่า 3× แต่ไม่ได้ให้เบนช์มาร์กบน Mac ที่เทียบเงื่อนไขตรงกันมาประกอบข้อความนั้น
บันทึกเบนช์มาร์กของ FluidAudio รายงาน Parakeet v3 ที่ RTFx รวม 155.6× และ WER เฉลี่ย 2.5% บนชุด LibriSpeech test-clean ที่มี 2,620 ไฟล์ ความยาว 5.40 ชั่วโมง วัดบน M4 Pro ปี 2024 ที่มี RAM 48 GB และ macOS 26.0
ผลลัพธ์นั้นเป็นของเซ็ตอัปของ FluidAudio README ของ MLX ทั้งสองตัวไม่ได้ตีพิมพ์ตัวเลขความเร็วบน Mac ที่คุมเงื่อนไข ตัวเลขเหล่านี้ไม่ใช่การเปรียบเทียบ runtime ที่เทียบเคียงกันได้ตรง ๆ คำสั่งทั้งหมดในนี้ยังไม่ได้รับการยืนยันบนเครื่องนี้
บน macOS 14 มีissue ของ parakeet-mlx รายงานว่าแครชที่ Metal API ซึ่งเพิ่มเข้ามาใน macOS 15 ให้อัปเกรด OS หรือใช้เวอร์ชัน MLX ที่เข้ากันได้ ถ้าการสตรีม add_audio() โยน TypeError ออกมา อีก issue หนึ่ง บอกให้แปลงอินพุต NumPy ด้วย mx.array(...)
ถ้าโมเดล Core ML ของ whisper.cpp โหลดไม่ผ่าน ให้จับคู่ encoder bundle ของมันกับ checkpoint ที่เลือกไว้ มีissue บน Mac หนึ่งที่รวบรวม error ของ Metal kernel ตอนรันไทม์บน Apple Silicon ไว้ ดังนั้นจดเวอร์ชัน macOS และ Xcode ของคุณไว้ถ้าเจอเข้า กรณีเหล่านี้เป็นเรื่องที่มีคนรายงานมา ไม่ได้เกิดกับทุกคน
ควรทดสอบอะไรบ้างก่อนเปลี่ยนจาก Whisper?
รันเสียงชุดเดียวกันผ่านทุกตัวที่เข้ารอบ ด้วยการ normalize แบบเดียวกัน แล้วจดทั้งจุดที่ต้องแก้ใน transcript และเวลาจริงที่ใช้
ใช้คลิป 10–20 คลิปจากงานของคุณเอง: การพูดสั่งงานในที่เงียบ เสียงรบกวนเบื้องหลัง ชื่อคนหรือคำศัพท์เทคนิค ช่วงหยุดสั้น ๆ และเสียงบันทึกยาว ๆ เก็บ transcript อ้างอิงของทุกคลิปไว้
สำหรับแต่ละ runtime ให้บันทึกโมเดล/เวอร์ชัน ภาษา ความยาวเสียง สิ่งที่ดาวน์โหลดตอนรันครั้งแรก เวลาจนถึงข้อความแรก เวลารวม หน่วยความจำสูงสุดถ้ามี และจำนวนคำที่ผิด เทียบเรื่องวรรคตอนแยกต่างหาก เพราะลีดเดอร์บอร์ด normalize วรรคตอนและตัวพิมพ์ใหญ่เล็กออกไปแล้ว ทำซ้ำแต่ละคลิปสองครั้งเพื่อไม่ให้การโหลดโมเดลถูกเข้าใจผิดว่าเป็นความเร็วในการถอดเสียง
ถ้าคุณต้องการภาษาเอาต์พุตที่ตายตัว คำศัพท์ที่กำหนดเอง หรือพฤติกรรมที่ไว้ใจได้ในช่วงเงียบ ให้รวมเคสเหล่านั้นเข้าไปด้วย การ์ดโมเดลของ NVIDIA เตือนว่าคำที่ไม่มีอยู่ใน language model ของมันอาจถูกพลาดไป ส่วน implementation ในผลิตภัณฑ์ของ Vext ก็ใช้ vocabulary booster ที่เป็นออปชันแยกต่างหากบันทึกเรื่อง on-device speech recognitionก่อนหน้าของเราอธิบายว่าทำไมเราถึงเก็บเส้นทางเสียงไว้บนเครื่อง แต่มันใช้แทนการวัดคำศัพท์และสำเนียงของคุณเองไม่ได้
ทางเลือกนี้หน้าตาเป็นอย่างไรใน Vext?
เราสร้าง Vext แอปแปลงเสียงเป็นข้อความบน Mac ที่ใช้ Parakeet TDT v3 ผ่าน FluidAudio และ Core ML บน Neural Engine ของ Apple ไฟล์ดาวน์โหลด Parakeet ของมันอยู่ที่ประมาณ 483 MB และครอบคลุม 25 ภาษายุโรปชุดเดียวกัน ภาษาอื่นจะถูกส่งไปที่ Apple Speech และ Vext ไม่ได้แนบ Whisper แบบโลคัลมาด้วย
เราเคยเขียนเรื่อง diarization แบบสองรอบและการรองรับภาษาของ Vext ไว้ด้วย README ของมันบอก “~150x realtime” โดยไม่มีเงื่อนไขการทดสอบบันทึกไว้ ตัวเลขที่วัดได้และใกล้เคียงที่สุดคือ 155.6× บน M4 Pro ของ FluidAudio เองข้างบน ซึ่งเป็นของไลบรารีที่ Vext รัน ไม่ใช่ของตัว Vext เอง
ถ้าภาษาของคุณอยู่ในลิสต์ของ Parakeet v3 ให้เริ่มจาก Parakeet กับ runtime บน Mac ที่คุณดูแลต่อได้ ถ้าคุณต้องการการรองรับภาษาที่กว้างกว่าของ Whisper หรือการแปลเป็นภาษาอังกฤษ ให้ใช้ large-v3 ถ้าคุณอยากได้ Whisper ตัวที่เล็กลงและไม่ต้องแปล ให้ลองเทียบ turbo แล้วเก็บตัวที่ชนะไว้ก็ต่อเมื่อมันทำให้ transcript บนเสียงของคุณเองดีขึ้น
— Don
ลองใช้คลิปชุดเดียวกันกับทั้งสองเอนจิน แล้วแชร์บันทึกเรื่องโมเดล runtime และฮาร์ดแวร์ของคุณมาให้เราที่ GitHub