NVIDIA Parakeet TDT puede parecer la alternativa correcta a Whisper hasta que falla con tu idioma o con tu flujo de trabajo. El runtime en tu Mac importa tanto como el checkpoint.
Respuesta corta: elige Parakeet TDT v3 si tu audio está en uno de sus 25 idiomas europeos admitidos y quieres un modelo de 600M de parámetros con marcas de tiempo por palabra. Elige Whisper large-v3 cuando necesites una cobertura amplia de idiomas o traducción al inglés; elige large-v3-turbo cuando quieras un checkpoint de Whisper más pequeño. En las tablas de inglés del artículo del Open ASR Leaderboard, Parakeet v3 tiene un WER medio más bajo que los dos checkpoints de Whisper, y en audio de formato corto se ejecuta 17–23 veces más rápido en la misma GPU; en cinco idiomas europeos empata con Whisper large-v3 en WER. Esas velocidades en GPU no predicen el rendimiento en tu Mac, así que elige un runtime y luego compara ambos modelos con los clips que transcribes de verdad.
¿Qué es NVIDIA Parakeet TDT y en qué se diferencia de Whisper?
Parakeet TDT usa un codificador de audio FastConformer y un decodificador Token-and-Duration Transducer. Whisper usa un Transformer codificador-decodificador que genera texto token a token. TDT predice cuánto audio cubre un token y puede saltarse esos frames de audio al decodificar. El artículo de TDT describe ese mecanismo de salto de frames; el artículo de Whisper describe su diseño codificador-decodificador.
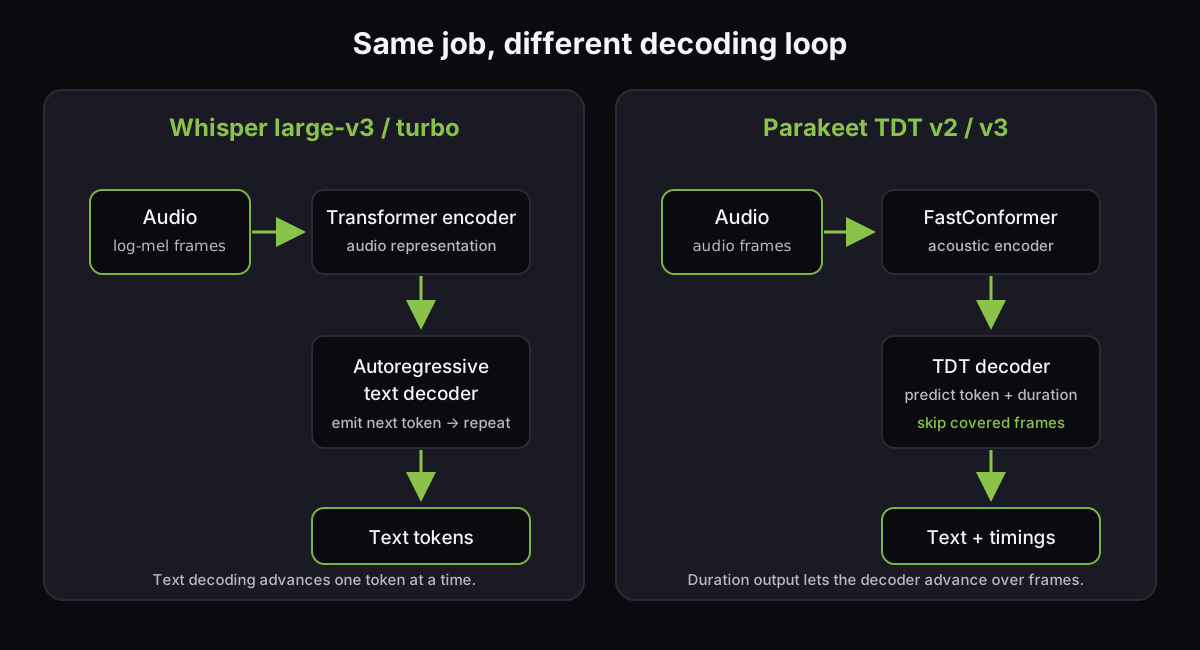
Esa arquitectura ayuda a explicar el throughput publicado de Parakeet; no demuestra que vayas a obtener mejores transcripciones para tu audio. Whisper cubre 99 idiomas según la ficha del modelo large-v3, y el README de Whisper documenta la traducción de voz al inglés. Parakeet v3 detecta automáticamente uno de sus idiomas admitidos, y su ficha del modelo advierte de que la precisión varía según el acento, el ruido, el dominio y el tipo de habla. No deduzcas de ahí que ninguno de los dos modelos invente palabras durante los silencios; las cifras de benchmark de más abajo no miden ese comportamiento.
¿Cómo se comparan Parakeet v2, v3, Whisper large-v3 y turbo?
El artículo del Open ASR Leaderboard (arXiv v4, March 30, 2026) recoge los cuatro checkpoints en inglés de formato corto y tres de ellos en inglés de formato largo. En el WER, cuanto más bajo mejor; el RTFx son los segundos de audio que el modelo transcribe por segundo de cómputo, así que cuanto más alto, más rápido.
| Checkpoint | Parámetros | Idiomas | Licencia | WER / RTFx en inglés de formato corto | WER / RTFx en inglés de formato largo |
|---|---|---|---|---|---|
| Parakeet TDT v2 | 600M | Inglés | CC BY 4.0 | 6.05% / 3,390 | no está en el subconjunto del artículo |
| Parakeet TDT v3 | 600M | 25 europeos | CC BY 4.0 | 6.32% / 3,330 | 10.7% / 1,000 |
| Whisper large-v3 | 1.55B | 99 | MIT en el repo de OpenAI; los metadatos de la ficha en HF dicen Apache-2.0 | 7.44% / 146 | 11.2% / 68.6 |
| Whisper large-v3-turbo | 809M | 99 | MIT | 7.83% / 200 | 11.0% / 148 |
En la tabla multilingüe del artículo, que promedia alemán, francés, italiano, español y portugués, Parakeet v3 y Whisper large-v3 obtienen ambos un WER medio del 4.81%, con un RTFx de 1,720 y 111. Parakeet va por delante en alemán y francés, Whisper en italiano, español y portugués. Las puntuaciones salen de las tablas 3–5 del artículo del leaderboard, que ejecuta cada modelo en una única NVIDIA A100-SXM4-80GB, con un tamaño de batch de 64 cuando la memoria lo permite y batches más pequeños en caso contrario. Trata el RTFx como una comparación en el mismo hardware, no como una estimación para Apple Silicon, y consulta el leaderboard en vivo por si hay filas más recientes.
La ficha de v2 indica transcripción solo en inglés, mientras que la ficha de v3 de NVIDIA nombra 25 idiomas: búlgaro, croata, checo, danés, neerlandés, inglés, estonio, finés, francés, alemán, griego, húngaro, italiano, letón, lituano, maltés, polaco, portugués, rumano, ruso, eslovaco, esloveno, español, sueco y ucraniano.
El README de Whisper de OpenAI dice que los pesos y el código usan MIT. La ficha de large-v3 en Hugging Face etiqueta ahora sus metadatos como Apache-2.0, así que comprueba los archivos que rigen la licencia para la distribución que tengas en mente en lugar de fiarte solo de una tabla comparativa. La ficha del modelo de turbo indica MIT.
Ambas fichas de Parakeet documentan puntuación y mayúsculas automáticas, además de marcas de tiempo a nivel de palabra. Whisper ofrece segmentos con marcas de tiempo; el README de mlx-whisper documenta marcas de tiempo a nivel de palabra en su salida de transcripción. Large-v3-turbo es un large-v3 podado con cuatro capas de decodificador en lugar de 32, según su ficha del modelo. Su tamaño más pequeño cambia parte de la precisión por throughput.
¿Qué modelo debería elegir para idiomas, traducción o grabaciones largas?
Empieza por el idioma y la salida que necesitas, y luego trata las puntuaciones de benchmark como desempate.
| Elección | Cuándo encaja | Coste o límite |
|---|---|---|
| Parakeet TDT v2 | Transcripción solo en inglés con puntuación y tiempos por palabra | Sin cobertura multilingüe |
| Parakeet TDT v3 | Uno de sus 25 idiomas europeos listados; quieres la arquitectura TDT y tiempos por palabra | No puede transcribir hindi, tailandés, japonés, árabe ni chino como idiomas admitidos; la ficha del modelo dice que detecta el idioma sin prompt, así que cuenta con comprobar las detecciones erróneas en clips cortos |
| Whisper large-v3 | Un idioma de la lista de 99 idiomas de Whisper, o traducción al inglés de voz en otro idioma | 1.55B de parámetros; checkpoint más grande |
| Whisper large-v3-turbo | La cobertura de idiomas de Whisper con un checkpoint podado de 809M | Turbo no está entrenado para traducir; usa el large-v3 completo para esa tarea |
Para grabaciones largas, distingue los límites del modelo del troceado del runtime. NVIDIA dice que Parakeet v3 admite hasta 24 minutos con atención completa en una A100 de 80 GB, o hasta tres horas con atención local. La ficha de v2 dice hasta 24 minutos por pasada. El artículo original de Whisper describe segmentos de entrada de 30 segundos; su README oficial documenta el camino de transcripción de audio largo. En un Mac, prueba el uso de memoria y el comportamiento de troceado del runtime con una grabación de duración completa antes de elegir un flujo de trabajo para producción.
¿Cómo puedo ejecutar Parakeet o Whisper en local en un Mac?
Requisitos previos: el paquete Swift de FluidAudio declara macOS 14+ y Swift tools 6.0. Las rutas con MLX apuntan a Apple Silicon, y una issue de parakeet-mlx informa de un fallo en macOS 14 causado por una API disponible en macOS 15, así que usa macOS 15+ para esa ruta salvo que verifiques una versión de MLX compatible. whisper.cpp admite Macs con Intel y con Apple Silicon. Los READMEs de los paquetes no fijan un conjunto común de versiones de Python/MLX.
Los comandos de abajo son solo de documentación: sus READMEs los documentan, pero no hemos instalado ni ejecutado ningún modelo para este artículo. Las primeras ejecuciones pueden descargar gigabytes de pesos, así que comprueba antes las necesidades de disco y memoria del modelo que elijas.
Parakeet a través de Core ML y FluidAudio: elige este runtime en Swift cuando quieras su pipeline de Core ML, que puede usar el Neural Engine de Apple. En un checkout de FluidAudio, la forma documentada del CLI es:
swift run fluidaudiocli transcribe meeting.wav
Resultado esperado: se imprime una transcripción del archivo WAV; la primera carga del modelo descarga los recursos de Core ML. El README de FluidAudio documenta esta ruta y su modelo v3. Esto requiere un proyecto Swift o el checkout del repositorio; no es una instalación de paquete desde el shell para uso general.
Parakeet MLX: elige este CLI de Python para una ruta por la GPU de Apple Silicon. Instala ffmpeg primero, como exige el README, y luego ejecuta:
brew install ffmpeg
uv tool install parakeet-mlx -U
parakeet-mlx meeting.wav --output-format txt
Resultado esperado: un archivo de transcripción en texto para meeting.wav; el modelo por defecto es mlx-community/parakeet-tdt-0.6b-v3. El README de parakeet-mlx documenta la instalación, los formatos de salida y el checkpoint por defecto.
MLX Whisper: elige esta ruta si quieres Whisper en la GPU de Apple Silicon y una API de Python. Instala y transcribe con un checkpoint de turbo convertido:
brew install ffmpeg
python -m pip install mlx-whisper
mlx_whisper meeting.wav --model mlx-community/whisper-large-v3-turbo
Resultado esperado: el CLI escribe un archivo de transcripción; el README de MLX Whisper documenta el paquete y el CLI, y el checkpoint de turbo convertido está disponible en la MLX Community. Para marcas de tiempo por palabra, usa su API de Python con word_timestamps=True.
Whisper a través de whisper.cpp: elige este runtime en C/C++ para un CLI nativo con Metal y soporte opcional de codificador Core ML. Desde su repositorio:
git clone https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
sh ./models/download-ggml-model.sh base.en
cmake -B build
cmake --build build -j --config Release
./build/bin/whisper-cli -f samples/jfk.wav
Resultado esperado: la transcripción de ejemplo aparece en el terminal. Este inicio rápido usa base.en, un checkpoint de 74M de parámetros solo en inglés; elige un modelo GGML multilingüe admitido para una comparación con Whisper large-v3. El README de whisper.cpp documenta el soporte de Metal y Core ML. Para compilar su codificador Core ML opcional en Apple Silicon, sigue la misma preparación del repositorio y luego ejecuta:
python3.11 -m pip install ane_transformers openai-whisper coremltools
./models/generate-coreml-model.sh base.en
cmake -B build -DWHISPER_COREML=1
cmake --build build -j --config Release
./build/bin/whisper-cli -m models/ggml-base.en.bin -f samples/jfk.wav
Resultado esperado: el terminal imprime una transcripción e informa de que se cargó el codificador Core ML correspondiente. La primera carga puede compilar el modelo para el Neural Engine. El README dice que este codificador puede ejecutarse más de 3× más rápido que la ejecución solo con CPU, pero no ofrece ningún benchmark comparable en Mac para esa afirmación.
El registro de benchmarks de FluidAudio sitúa a Parakeet v3 en 155.6× de RTFx global y un WER medio del 2.5% en el conjunto LibriSpeech test-clean de 2,620 archivos y 5.40 horas, medido en un M4 Pro de 2024 con 48 GB de RAM y macOS 26.0.
Ese resultado pertenece a la configuración de FluidAudio; ninguno de los dos READMEs de MLX publica una cifra controlada de velocidad en Mac. Estos números no forman una comparación de runtimes en igualdad de condiciones. Todos los comandos de aquí siguen sin verificarse en esta máquina.
En macOS 14, una issue de parakeet-mlx informa de un cuelgue con una API de Metal añadida en macOS 15; actualiza el sistema operativo o usa una versión de MLX compatible. Si el streaming de add_audio() lanza un TypeError, otra issue dice que conviertas la entrada de NumPy con mx.array(...).
Si el modelo Core ML de whisper.cpp no se carga, haz que su bundle de codificador coincida con el checkpoint seleccionado; una issue de Mac recopila errores de kernels de Metal en tiempo de ejecución en Apple Silicon, así que anota tus versiones de macOS y Xcode si te encuentras con uno. Son casos reportados, no fallos universales.
¿Qué debería probar antes de reemplazar Whisper?
Pasa el mismo audio por cada candidato con la misma normalización y anota tanto las correcciones de la transcripción como el tiempo real transcurrido.
Usa 10–20 clips de tu propio trabajo: dictado en un entorno silencioso, ruido de fondo, nombres o términos técnicos, pausas cortas y una grabación larga. Conserva la transcripción de referencia de cada uno.
Para cada runtime, registra el modelo/versión, el idioma, la duración del audio, la descarga de la primera ejecución, el tiempo hasta el primer texto, el tiempo total, el pico de memoria si está disponible y los errores de palabras. Compara la puntuación por separado porque el leaderboard normaliza y elimina la puntuación y las mayúsculas. Repite cada clip dos veces para no confundir la carga del modelo con la velocidad de transcripción.
Si necesitas un idioma de salida fijo, vocabulario personalizado o un comportamiento fiable ante los silencios, incluye esos casos exactos. La ficha del modelo de NVIDIA advierte de que las palabras ausentes de su modelo de lenguaje pueden no reconocerse; la implementación de producto de Vext usa además un potenciador de vocabulario opcional y separado. Nuestra nota anterior sobre reconocimiento de voz en el dispositivo explica por qué mantenemos la ruta del audio en local, pero no sustituye a medir tus propios términos y acentos.
¿Cómo se ve esta elección en Vext?
Nosotros construimos Vext, una app de voz a texto para Mac que usa Parakeet TDT v3 a través de FluidAudio y Core ML en el Neural Engine de Apple. Su descarga de Parakeet son unos 483 MB y cubre los mismos 25 idiomas europeos; los demás idiomas se enrutan a Apple Speech, y Vext no incluye Whisper local.
También hemos escrito sobre la diarización en dos pasadas y el soporte de idiomas de Vext. Su README dice «~150x realtime» sin condiciones de prueba registradas; la cifra medida más cercana es el 155.6× de FluidAudio en un M4 Pro que aparece más arriba, y corresponde a la biblioteca que ejecuta Vext, no a Vext en sí.
Si tu idioma está en la lista de Parakeet v3, empieza con Parakeet y con un runtime para Mac que puedas mantener. Si necesitas la cobertura de idiomas más amplia de Whisper o la traducción al inglés, usa large-v3; si necesitas la variante más pequeña de Whisper y no necesitas traducción, compara turbo. Y quédate con el ganador solo si mejora tus transcripciones con tu propio audio.
— Don
Prueba los mismos clips con ambos motores y comparte con nosotros tus notas de modelo, runtime y hardware en GitHub.