NVIDIA Parakeet TDT может выглядеть правильной альтернативой Whisper — ровно до тех пор, пока не выяснится, что ваш язык или ваш рабочий процесс он не покрывает. Рантайм на вашем Mac важен не меньше, чем чекпоинт.
Короткий ответ: выбирайте Parakeet TDT v3, если ваше аудио на одном из 25 поддерживаемых им европейских языков и вам нужна модель на 600M параметров с таймстемпами слов. Выбирайте Whisper large-v3, когда нужно широкое покрытие языков или перевод на английский; large-v3-turbo — когда нужен чекпоинт Whisper поменьше. В англоязычных таблицах статьи об Open ASR Leaderboard у Parakeet v3 средний WER ниже, чем у обоих чекпоинтов Whisper, а на коротком аудио он работает в 17–23 раза быстрее на том же GPU; на пяти европейских языках его WER совпадает с WER Whisper large-v3. Эти скорости на GPU не предсказывают производительность на вашем Mac, поэтому сначала выберите рантайм, а затем сравните обе модели на тех записях, которые вы действительно транскрибируете.
Что такое NVIDIA Parakeet TDT и чем он отличается от Whisper?
Parakeet TDT использует аудиоэнкодер FastConformer и декодер Token-and-Duration Transducer. Whisper — это Transformer типа encoder-decoder, который генерирует текст по одному токену за раз. TDT предсказывает, какой отрезок покрывает токен, и при декодировании может пропускать соответствующие аудиокадры. В статье о TDT описан этот механизм пропуска кадров; в статье о Whisper — его encoder-decoder-архитектура.
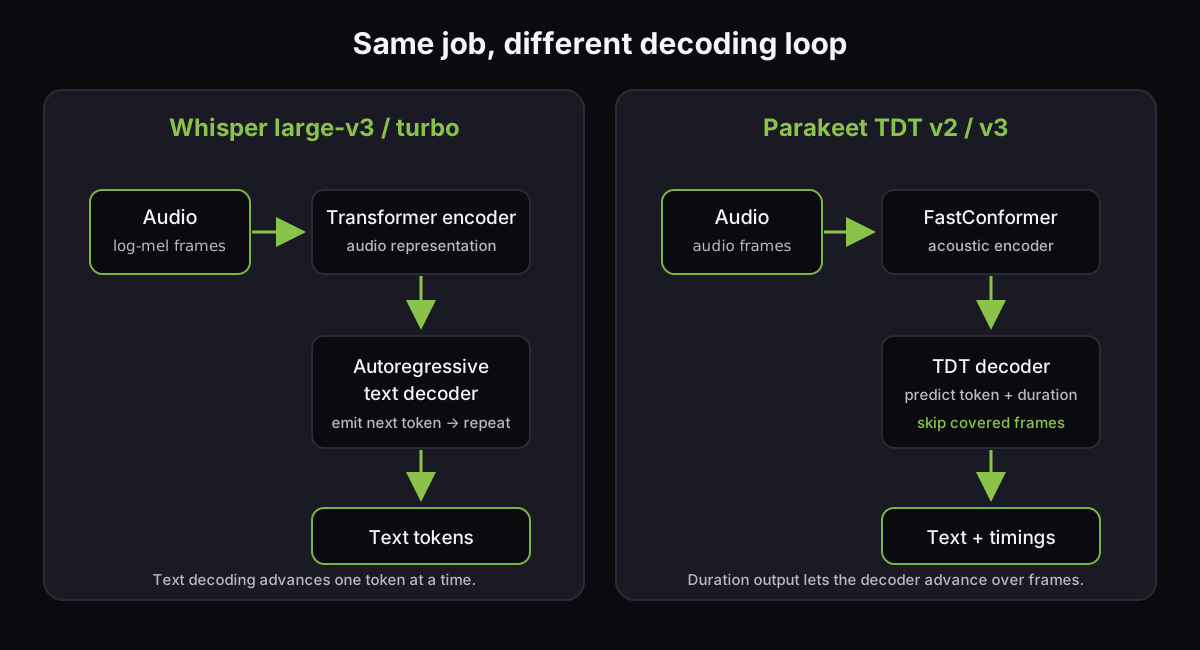
Такая архитектура помогает объяснить опубликованную пропускную способность Parakeet; она не доказывает, что на вашем аудио транскрипты будут лучше. Согласно карточке модели large-v3, Whisper покрывает 99 языков, а README Whisper документирует перевод речи на английский. Parakeet v3 автоматически определяет один из поддерживаемых им языков, и его карточка модели предупреждает, что точность зависит от акцента, шума, предметной области и типа речи. Не делайте отсюда вывод, что ни одна из моделей никогда не выдумывает слова в тишине: приведённые ниже бенчмарки такое поведение не измеряют.
Как соотносятся Parakeet v2, v3, Whisper large-v3 и turbo?
Статья об Open ASR Leaderboard (arXiv v4, 30 марта 2026 года) приводит результаты всех четырёх чекпоинтов на коротком английском аудио и трёх из них — на длинном. WER — чем ниже, тем лучше; RTFx — сколько секунд аудио модель транскрибирует за секунду вычислений, так что чем выше, тем быстрее.
| Чекпоинт | Параметры | Языки | Лицензия | Английский, короткое аудио: WER / RTFx | Английский, длинное аудио: WER / RTFx |
|---|---|---|---|---|---|
| Parakeet TDT v2 | 600M | английский | CC BY 4.0 | 6.05% / 3,390 | нет в выборке статьи |
| Parakeet TDT v3 | 600M | 25 европейских | CC BY 4.0 | 6.32% / 3,330 | 10.7% / 1,000 |
| Whisper large-v3 | 1.55B | 99 | MIT в репозитории OpenAI; в метаданных карточки на HF указано Apache-2.0 | 7.44% / 146 | 11.2% / 68.6 |
| Whisper large-v3-turbo | 809M | 99 | MIT | 7.83% / 200 | 11.0% / 148 |
В мультиязычной таблице статьи, где усредняются немецкий, французский, итальянский, испанский и португальский, Parakeet v3 и Whisper large-v3 показывают одинаковый средний WER 4.81% при RTFx 1,720 и 111 соответственно. Parakeet впереди на немецком и французском, Whisper — на итальянском, испанском и португальском. Оценки взяты из таблиц 3–5 статьи о лидерборде, где каждая модель запускается на одной NVIDIA A100-SXM4-80GB с размером батча 64, если хватает памяти, и с меньшими батчами в противном случае. К RTFx стоит относиться как к сравнению на одинаковом железе, а не как к оценке для Apple Silicon, и проверять живой лидерборд на более свежие строки.
В карточке v2 указана транскрипция только на английском, тогда как карточка v3 от NVIDIA называет 25 языков: болгарский, хорватский, чешский, датский, нидерландский, английский, эстонский, финский, французский, немецкий, греческий, венгерский, итальянский, латышский, литовский, мальтийский, польский, португальский, румынский, русский, словацкий, словенский, испанский, шведский и украинский.
В README Whisper от OpenAI сказано, что веса и код распространяются под MIT. Карточка large-v3 на Hugging Face сейчас помечает свои метаданные как Apache-2.0, поэтому для предполагаемого способа распространения проверяйте определяющие это файлы, а не полагайтесь только на сравнительную таблицу. В карточке модели turbo указан MIT.
Обе карточки Parakeet документируют автоматическую пунктуацию и расстановку заглавных букв, а также таймстемпы на уровне слов. Whisper выдаёт сегменты с таймстемпами; README mlx-whisper документирует таймстемпы слов в выводе транскрипции. Large-v3-turbo, согласно его карточке модели, — это прореженный large-v3 с четырьмя слоями декодера вместо 32. Меньший размер означает, что часть точности обменяна на пропускную способность.
Какую модель выбрать под языки, перевод или длинные записи?
Сначала исходите из нужного вам языка и формата вывода, а оценки бенчмарков используйте как тай-брейк.
| Выбор | Когда подходит | Цена или ограничение |
|---|---|---|
| Parakeet TDT v2 | Транскрипция только на английском, с пунктуацией и временем слов | Нет мультиязычного покрытия |
| Parakeet TDT v3 | Один из 25 перечисленных европейских языков; вам нужны архитектура TDT и время слов | Не может транскрибировать хинди, тайский, японский, арабский или китайский как поддерживаемые языки; в карточке модели сказано, что язык определяется без промпта, поэтому заложите проверку ошибочных определений на коротких записях |
| Whisper large-v3 | Язык из списка 99 языков Whisper или перевод неанглоязычной речи на английский | 1.55B параметров; более крупный чекпоинт |
| Whisper large-v3-turbo | Языковое покрытие Whisper с прореженным чекпоинтом на 809M | Turbo не обучен для перевода; для этой задачи используйте полный large-v3 |
Для длинных записей разделяйте ограничения модели и нарезку на чанки в рантайме. NVIDIA говорит, что Parakeet v3 поддерживает до 24 минут с полным вниманием на 80 GB A100 или до трёх часов с локальным вниманием. В карточке v2 сказано: до 24 минут за проход. В исходной статье Whisper описаны 30-секундные входные сегменты; его официальный README документирует путь транскрипции длинного аудио. На Mac перед выбором рабочего процесса для продакшена проверьте потребление памяти рантаймом и его поведение при нарезке на чанки на записи полной длины.
Как запустить Parakeet или Whisper локально на Mac?
Требования: Swift-пакет FluidAudio объявляет macOS 14+ и Swift tools 6.0. Пути на MLX рассчитаны на Apple Silicon, а в issue parakeet-mlx сообщается о сбое на macOS 14 из-за API, доступного в macOS 15, поэтому для этого пути используйте macOS 15+, если не проверили совместимую версию MLX. whisper.cpp поддерживает Mac на Intel и на Apple Silicon. В README пакетов не зафиксирован общий набор версий Python/MLX.
Команды ниже — только по документации: они описаны в соответствующих README, но для этой статьи мы не устанавливали и не запускали ни одну модель. Первый запуск может скачать гигабайты весов, поэтому сначала проверьте требования выбранной модели к диску и памяти.
Parakeet через Core ML и FluidAudio: выбирайте этот Swift-рантайм, если вам нужен его Core ML-пайплайн, который может использовать Neural Engine от Apple. В чекауте FluidAudio документирована такая форма CLI:
swift run fluidaudiocli transcribe meeting.wav
Ожидаемый результат: для WAV-файла печатается транскрипт; при первой загрузке модели скачиваются ассеты Core ML. README FluidAudio документирует этот путь и его модель v3. Для этого нужен Swift-проект или чекаут репозитория; как обычный пакет для шелла это не устанавливается.
Parakeet MLX: выбирайте этот Python-CLI для пути через GPU Apple Silicon. Сначала, как требует README, установите ffmpeg, затем запустите:
brew install ffmpeg
uv tool install parakeet-mlx -U
parakeet-mlx meeting.wav --output-format txt
Ожидаемый результат: текстовый файл транскрипта для meeting.wav; модель по умолчанию — mlx-community/parakeet-tdt-0.6b-v3. README parakeet-mlx документирует установку, форматы вывода и чекпоинт по умолчанию.
MLX Whisper: выбирайте этот путь, если вам нужны Whisper на GPU Apple Silicon и Python API. Установите пакет и транскрибируйте с конвертированным чекпоинтом turbo:
brew install ffmpeg
python -m pip install mlx-whisper
mlx_whisper meeting.wav --model mlx-community/whisper-large-v3-turbo
Ожидаемый результат: CLI записывает файл транскрипта; README MLX Whisper документирует пакет и CLI, а конвертированный чекпоинт turbo доступен от MLX Community. Для таймстемпов слов используйте его Python API с word_timestamps=True.
Whisper через whisper.cpp: выбирайте этот C/C++-рантайм ради нативного CLI с поддержкой Metal и опционального энкодера Core ML. Из его репозитория:
git clone https://github.com/ggml-org/whisper.cpp
cd whisper.cpp
sh ./models/download-ggml-model.sh base.en
cmake -B build
cmake --build build -j --config Release
./build/bin/whisper-cli -f samples/jfk.wav
Ожидаемый результат: в терминале появляется транскрипт примера. Этот быстрый старт использует base.en — чекпоинт на 74M параметров только для английского; для сравнения с Whisper large-v3 возьмите поддерживаемую мультиязычную GGML-модель. README whisper.cpp документирует поддержку Metal и Core ML. Чтобы собрать его опциональный энкодер Core ML на Apple Silicon, выполните ту же настройку репозитория, а затем запустите:
python3.11 -m pip install ane_transformers openai-whisper coremltools
./models/generate-coreml-model.sh base.en
cmake -B build -DWHISPER_COREML=1
cmake --build build -j --config Release
./build/bin/whisper-cli -m models/ggml-base.en.bin -f samples/jfk.wav
Ожидаемый результат: терминал печатает транскрипт и сообщает, что соответствующий энкодер Core ML загрузился. При первой загрузке модель может компилироваться для Neural Engine. В README сказано, что этот энкодер может работать более чем в 3 раза быстрее выполнения только на CPU, но сопоставимого бенчмарка на Mac к этому утверждению не приводится.
Журнал бенчмарков FluidAudio сообщает о Parakeet v3 с общим RTFx 155.6× и средним WER 2.5% на наборе LibriSpeech test-clean из 2,620 файлов общей длительностью 5.40 часа; измерения выполнены на M4 Pro 2024 года с 48 GB RAM и macOS 26.0.
Этот результат относится к сетапу FluidAudio; ни один из README MLX не публикует контролируемую цифру скорости на Mac. Сопоставимого сравнения рантаймов в одинаковых условиях эти числа не дают. Все команды здесь остаются непроверенными на этой машине.
На macOS 14 в issue parakeet-mlx сообщается о падении на Metal API, добавленном в macOS 15; обновите ОС или используйте совместимую версию MLX. Если потоковый add_audio() выдаёт TypeError, в другом issue советуют конвертировать вход NumPy через mx.array(...).
Если модель Core ML в whisper.cpp не загружается, сверьте её бандл энкодера с выбранным чекпоинтом; в одном Mac issue собраны рантайм-ошибки Metal-ядер на Apple Silicon, поэтому при столкновении с такой ошибкой запишите свои версии macOS и Xcode. Это сообщённые случаи, а не повсеместные сбои.
Что стоит проверить, прежде чем заменять Whisper?
Прогоните одно и то же аудио через каждого кандидата с одинаковой нормализацией и зафиксируйте и правки транскрипта, и фактическое время прогона.
Возьмите 10–20 записей из своей работы: тихая диктовка, фоновый шум, имена или технические термины, короткие паузы и одна длинная запись. Сохраните эталонный транскрипт для каждой.
Для каждого рантайма записывайте модель/версию, язык, длительность аудио, объём скачивания при первом запуске, время до первого текста, общее время, пиковое потребление памяти, если оно доступно, и ошибки распознавания слов. Пунктуацию сравнивайте отдельно, потому что лидерборд нормализует её и регистр букв. Повторяйте каждую запись дважды, чтобы загрузку модели не приняли за скорость транскрипции.
Если вам нужны фиксированный язык вывода, собственный словарь или надёжное поведение на тишине, включите в тест именно эти случаи. Карточка модели от NVIDIA предупреждает, что слова, отсутствующие в её языковой модели, могут быть пропущены; в продуктовой реализации Vext также используется отдельный опциональный бустер словаря. Наша более ранняя заметка о распознавании речи на устройстве объясняет, почему мы держим аудиопуть локально, но она не заменяет измерения на ваших собственных терминах и акцентах.
Как этот выбор выглядит в Vext?
Мы делаем Vext — приложение голос-в-текст для Mac, которое использует Parakeet TDT v3 через FluidAudio и Core ML на Neural Engine от Apple. Скачивание Parakeet в нём занимает около 483 MB и покрывает те же 25 европейских языков; остальные языки уходят в Apple Speech, а локальный Whisper в Vext не входит.
Мы также писали о двухпроходной диаризации и поддержке языков в Vext. В его README сказано «~150x realtime» без зафиксированных условий теста; ближайшее измеренное значение — те самые 155.6× FluidAudio на M4 Pro выше, и оно относится к библиотеке, на которой работает Vext, а не к самому Vext.
Если ваш язык есть в списке Parakeet v3, начните с Parakeet и рантайма для Mac, который вы способны поддерживать. Если вам нужны более широкое языковое покрытие Whisper или перевод на английский, используйте large-v3; если нужна меньшая версия Whisper и перевод не нужен, сравните turbo. А победителя оставляйте только в том случае, если он улучшает ваши транскрипты на вашем собственном аудио.
— Don
Прогоните те же записи через оба движка и поделитесь с нами своими заметками о модели, рантайме и железе на GitHub.